
ما سالها عادت کرده بودیم که اینترنت و موتورهای جستوجو مثل یک کتابخانهی دقیق و دائمی باشند؛ اما واقعیت این است که این فضا در حال تغییر است.
از یک طرف، هوش مصنوعی گاهی جوابهای نادرست و یا اطلاعات ساختگی تحویل میدهد. از طرف دیگر، بسیاری از سایتها، مقالهها و اطلاعات قدیمی در حال پاک شدن از روی اینترنت هستند.
همزمان، تلاش برای آلودهکردن منابع هوش مصنوعی نیز آغاز شده است. پژوهشگران نمونههایی پیدا کردهاند که در آن شرکتها یا صاحبان سایتها محتوایی هدفمند منتشر میکنند تا محصولاتشان در پاسخهای هوش مصنوعی بالاتر از رقبا پیشنهاد شود. یعنی همان صفحات عمومیای که این سیستمها برای ساختن پاسخ میخوانند، میتوانند عمداً دستکاری شوند.
این مطلب با نگاهی به تحلیل واس بِدنار در مجله The Walrus به خطری بزرگتر از یک پاسخ اشتباه میپردازد: با حذف منابع اصلی و جایگزینشدن آنها با خلاصههای هوش مصنوعی، هم حافظه اینترنت آسیب میبیند و هم تشخیص منشأ و اعتبار اطلاعات دشوارتر میشود.
بایگانیهایی که بیصدا از بین میروند
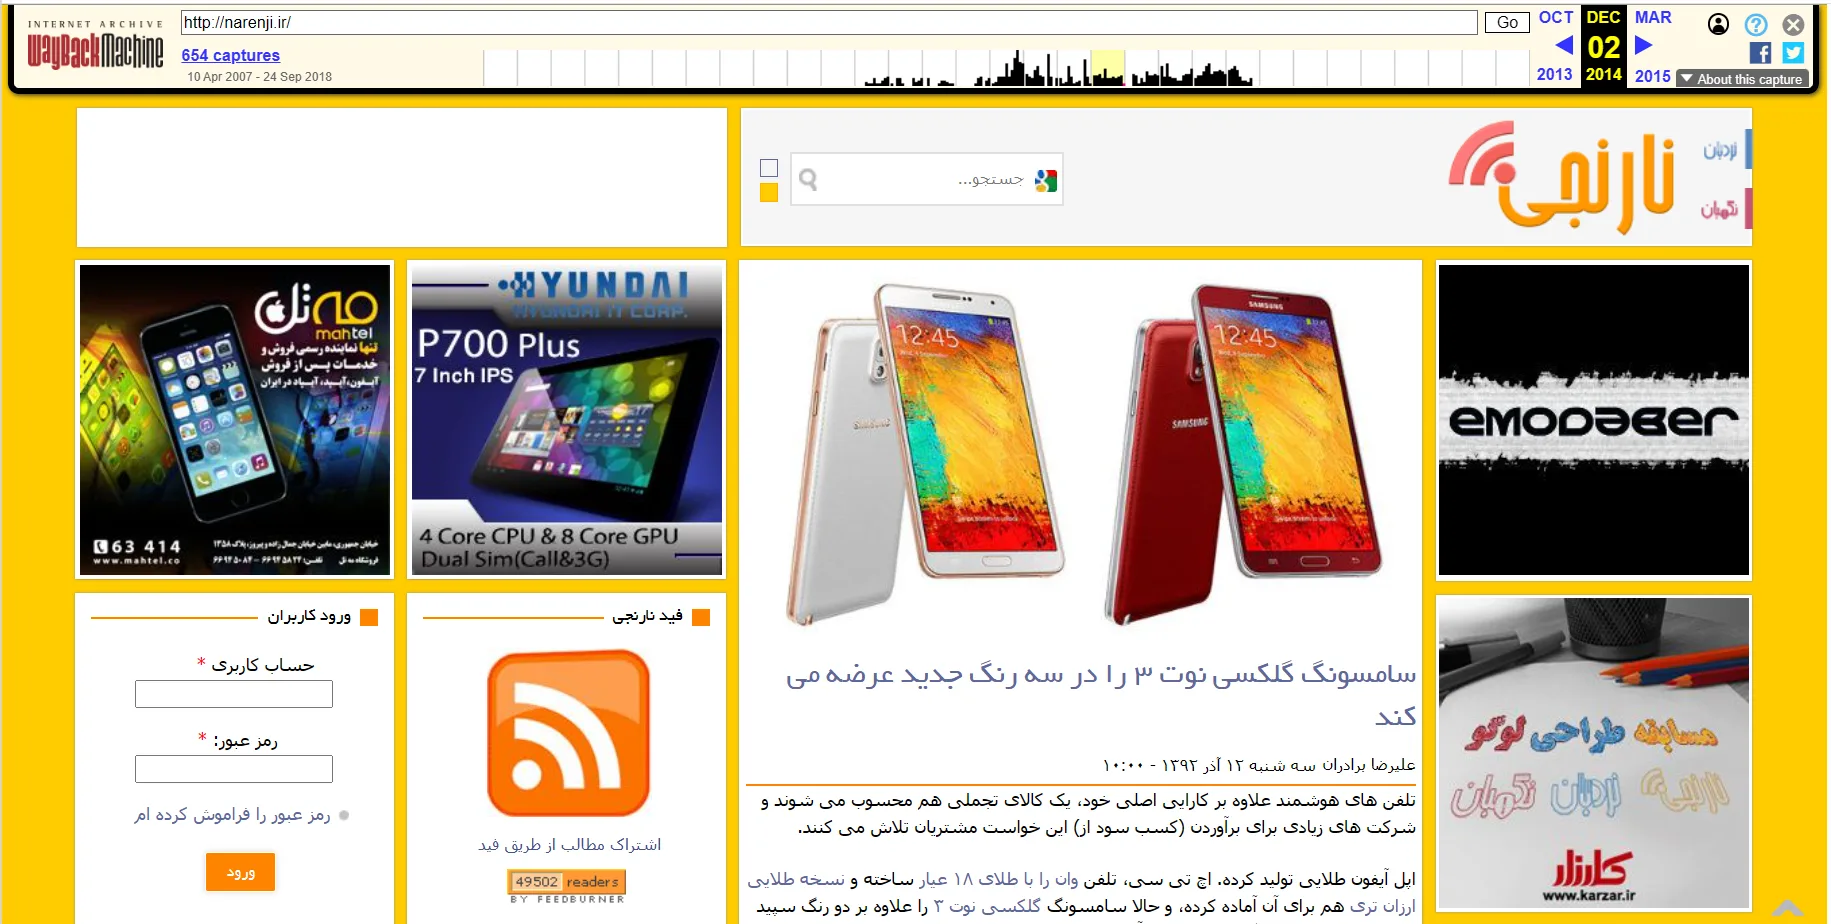
وضعیت برای بایگانی اینترنت (Internet Archive) نگرانکننده است. این کتابخانهی دیجیتال غیرانتفاعی که به خاطر سرویس «ویبک ماشین» (Wayback Machine)1 خود شناخته میشود، نزدیکترین چیزی است که وب به یک حافظه پشتیبان مطمئن دارد. این سرویس صدها میلیارد نسخه از صفحات وب را نگهداری میکند و روزنامهنگاران، پژوهشگران و حقوقدانان برای بازیابی صفحات حذفشده و راستیآزمایی ادعاهای گذشته به آن تکیه میکنند؛ اما این نهاد اکنون زیر فشار سنگین هزینههای نگهداریِ آرشیوی که مدام بزرگتر میشود، حملات سایبری و شکایتهای حقوقی قرار دارد.
بسیاری از سازمانهای خبری هم از ترس اینکه صفحات آرشیوشده به منبعی غیرمستقیم برای دسترسی شرکتهای هوش مصنوعی به محتوای دارای حق نشر تبدیل شود، دسترسی خزندههای ویبک ماشین را به صفحات خود مسدود کردهاند.
زیرساختهای دانشی که در مسیر فرسایشاند
بحران فقط به ناپدیدشدن صفحات قدیمی محدود نیست. سامانههای هوش مصنوعی و موتورهای جستوجو از محتوای ویکیپدیا برای ساختن پاسخهای مستقیم استفاده میکنند؛ اما کاربر لزوماً برای دیدن منبع، بررسی ارجاعات یا مشارکت در دانشنامه وارد خود ویکیپدیا نمیشود.
بنیاد ویکیمدیا میگوید بازدید انسانی این دانشنامه در چند ماه بررسیشده حدود ۸ درصد نسبت به مدت مشابه سال ۲۰۲۴ کاهش یافته و احتمال میدهد گسترش پاسخهای هوش مصنوعی و شبکههای اجتماعی در این روند نقش داشته باشد. این بنیاد هشدار میدهد اگر کاربران کمتری مستقیماً به ویکیپدیا مراجعه کنند، در بلندمدت ممکن است افراد کمتری به جمع نویسندگان داوطلب و حامیان مالی آن بپیوندند.
تناقض ماجرا همینجاست: هوش مصنوعی برای پاسخدادن به دانش گردآوریشده در ویکیپدیا وابسته است، اما ممکن است همان بازدید و مشارکتی را کاهش دهد که ادامه تولید این دانش را ممکن میکند. ویکیپدیا هنوز در حال «نابودی» نیست؛ نگرانی اصلی، شکلگیری چرخهای است که در آن محتوا مصرف میشود، بدون اینکه کاربر یا ارزش ایجادشده به منبع اصلی بازگردد.
دولتهایی که دنبال جایگزین رفتهاند
دولتهای اروپایی برای مقابله با این انحصار دستبهکار شدهاند. فرانسه موتور جستوجوی بومی و امن «کوانت» (Qwant) را جایگزین گوگل در نهادهای دولتی کرده تا امنیت سایبری و حاکمیت دیجیتالش را حفظ کند.
برخی دولتهای اروپایی هم در حال مهاجرت از محصولات مایکروسافت به گزینههای متنباز هستند. آنها فهمیدهاند که گرهخوردن زیرساخت دیجیتال یک کشور به چند شرکت خارجی، آسیبپذیری خطرناکی است.

چه کسی مسئول خطاهای هوش مصنوعی است؟
این روحیه مبارزهجویانه، برخی کشورها را به قدمهای بزرگتری واداشته است. دادگاهی در آلمان گوگل را مسئول اطلاعات نادرستی دانست که قابلیت «خلاصهی هوش مصنوعی» (AI Overview) این شرکت تولید کرده بود.
گوگل به این حکم اعتراض کرده، اما پیام اصلی منتقل شده است: مراقبت از اقتصاد اطلاعات دیگر نمیتواند پروژه حاشیهایِ نهادهای کمبودجه باشد. ویکیپدیا همانقدر معجزهآساست که ویبکماشین ضروری است؛ اما باید این توهم را کنار بگذاریم که کار داوطلبانه بهتنهایی میتواند اینترنت عمومی را سرپا نگه دارد.
ما این مسئولیت را در حوزههای دیگر بهخوبی درک میکنیم: جادهها را شرکتهای تاکسیرانی اینترنتی اداره نمیکنند؛ اپلیکیشنهای پرداخت، سیاستهای پولی را تعیین نمیکنند؛ با این حال دربارهی وابستگیهای دیجیتالمان بهطرز عجیبی بیخیال بودهایم.
حرف آخر
اینترنتی که در آینده از راه میرسد، ممکن است فضایی عجیبتر و بسیار مصنوعیتر باشد: شبکهای که ماشینها فقط تکههایی از آن را بهطور تصادفی به یاد میآورند و واسطهها از آن پول درمیآورند؛ اما این آینده میتواند شکل محکمتری هم داشته باشد: اینترنتی که مثل یک «زیرساخت عمومی» با آن برخورد شود؛ جایی که حافظه تاریخی ما در آن حفظ میشود، نه به این دلیل که برای کسی سودآور است، بلکه صرفاً چون متعلق به خود ماست.
آینده دانش عمومی فقط به اطلاعاتی که امروز وجود دارند بستگی ندارد؛ بلکه به این بستگی دارد که چه کسی انگیزه و اراده حفظ آنها را برای فردا دارد. حتی همین مقالهای که الان خواندید هم شاید تا ابد روی اینترنت نماند، شاید هم بماند؛ کسی چه میداند!
- ماشین زمان (Wayback Machine): سرویسی از بایگانی اینترنت که نسخههای قدیمی صفحات وب را در تاریخهای مختلف ذخیره میکند تا در صورت حذف نسخهی اصلی، همچنان قابل دسترس باشند. ↩︎
آدرس مطلب: https://nooshdaroo.ir/digital-literacy/ai-search-and-web-decay/