
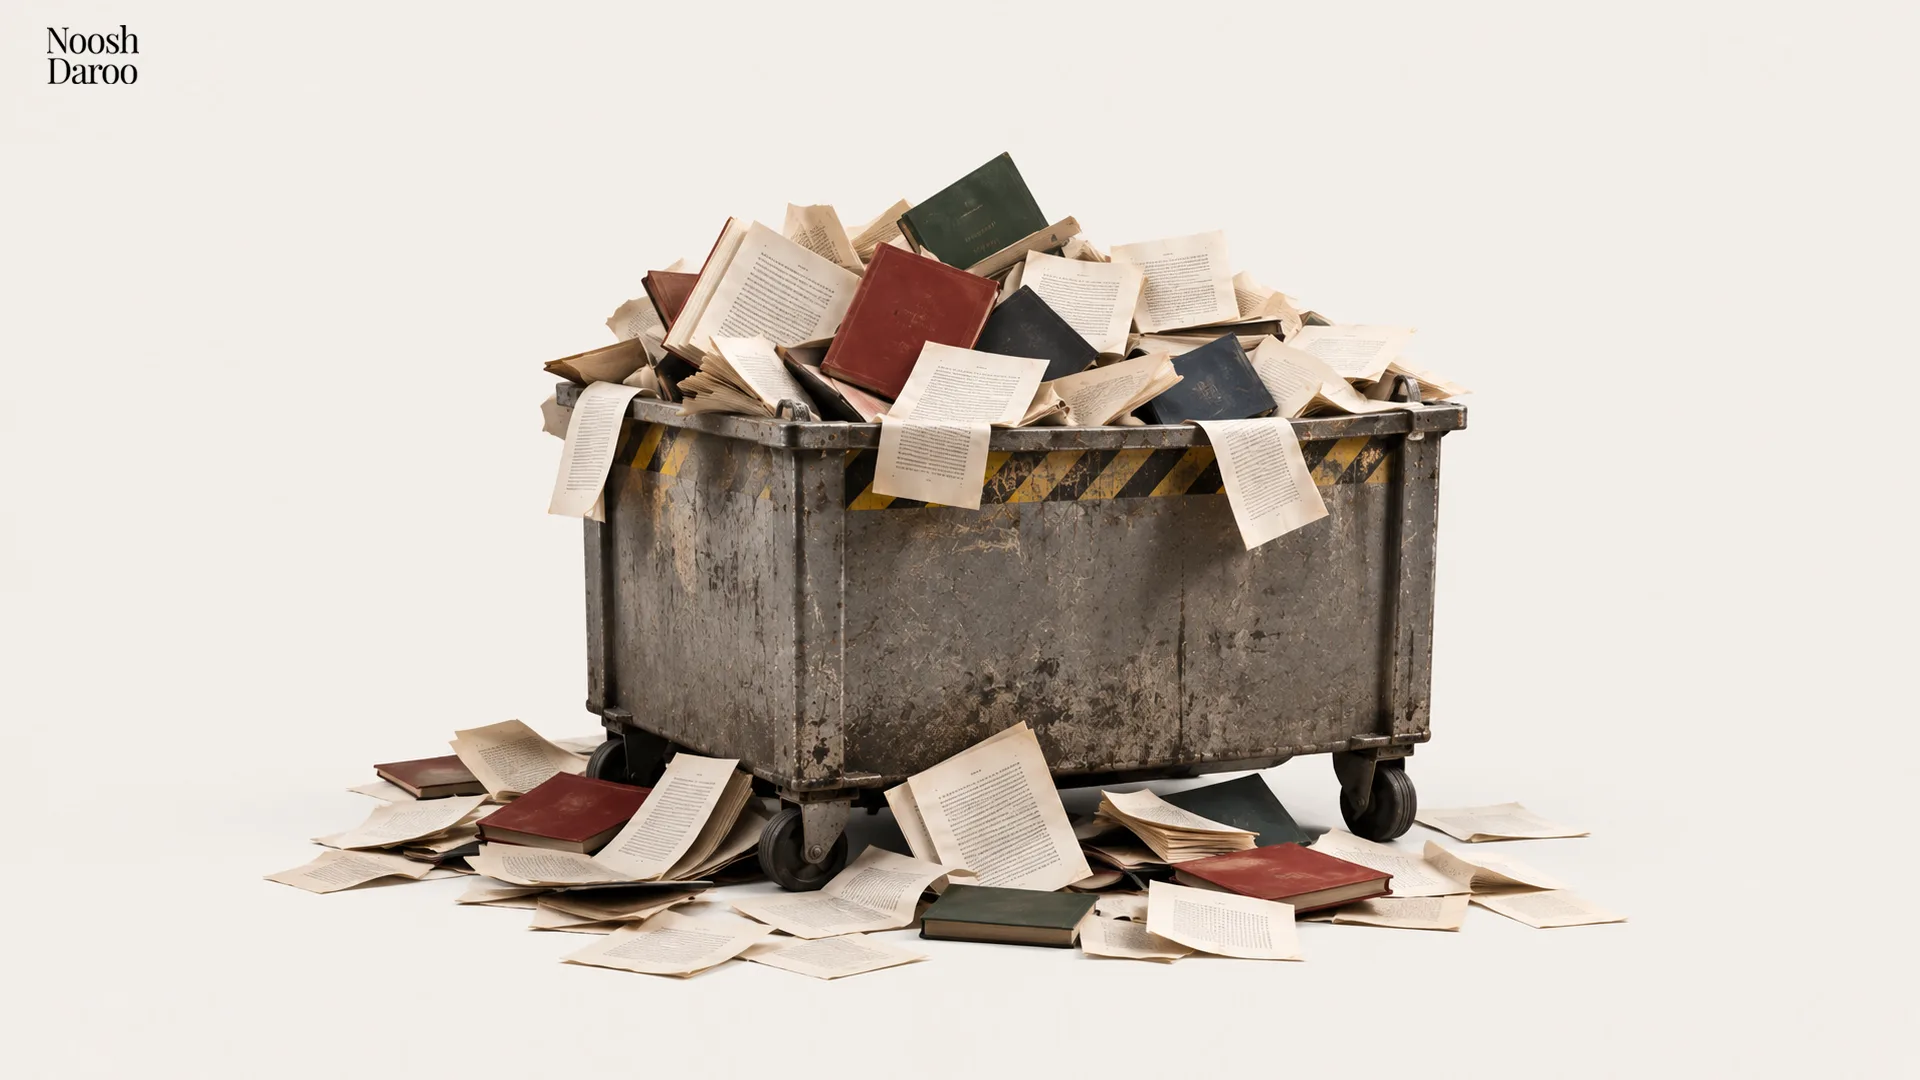
آمازون که سه دهه پیش کارش را با فروش کتاب آغاز کرد، حالا در مقیاس بزرگ کتاب میخرد تا محتوای آنها را به دادههای آموزشی تبدیل کند. گزارش تحقیقی جدید رسانه «۴۰۴ مدیا» (404 Media) نشان میدهد این شرکت کتابهای فیزیکی را میخرد، شیرازه آنها را میبُرد، صفحات را برای آموزش هوش مصنوعی اسکن میکند و در نهایت نسخه اصلی را از بین میبرد.
وقتی یک ردیاب کوچک دست آمازون را رو کرد
اماجرا زمانی آشکار شد که یک کتابفروش سفارش غیرمعمولی برای خرید حدود هزار جلد کتاب قدیمی و کمیاب دریافت کرد. خبرنگاران ۴۰۴ مدیا با همکاری او، یک ردیاب «ایرتگ» (AirTag) را داخل یکی از کتابهای این محموله قرار دادند و مسیر آن را تا یکی از انبارهای آمازون در نورث لاسوگاس دنبال کردند.
سخنگوی آمازون در واکنش به این گزارش به نشریه Inc. گفت که این شرکت کتابها را از مجاری تجاری میخرد تا محصولات و خدمات خود را توسعه دهد. با این حال، آمازون به سؤالات مهمی مانند تعداد کتابهای خریداریشده، زمان شروع برنامه و اینکه آیا نسخههای کمیاب پیش از نابودی جدا میشوند یا نه، پاسخی نداد.
بررسیهای نشریه Inc. نشان میدهد این روند احتمالاً از سال ۲۰۲۴ در جریان است. در آن زمان، فروشندگان آمازون از موج عجیب سفارشهای عمده به مقصد همین انبار در لاسوگاس خبر داده بودند؛ سفارشهایی که گاهی شامل دهها جلد کتاب انتشارات دانشگاهی در نیمههای شب بود. آمازون هنوز تأیید نکرده که آیا آن خریدها هم بخشی از همین پروژه اسکن بودهاند یا خیر.
چرا هوش مصنوعی به جان کتابهای قدیمی افتاده است؟
روی آوردن شرکتهای فناوری به کتابهای کاغذی، ریشه در یک محدودیت جدی دارد: پایان یافتن متنهای باکیفیت انسانی در اینترنت. کتابهای قدیمی و آفلاین حاوی مطالبی هستند که شاید هرگز در وب منتشر نشده باشند و مهمتر از آن، پیش از دوران تولید انبوه محتوای ماشینی نوشته شدهاند.
مؤسسه تحقیقاتی «اپک ایآی» (Epoch AI) برآورد کرده است که اگر روند فعلی توسعه مدلها ادامه پیدا کند، مجموعه متنهای عمومی و باکیفیت موجود برای آموزش ممکن است بین سالهای ۲۰۲۶ تا ۲۰۳۲ تقریباً بهطور کامل استفاده شود. این پیشبینی به معنی پایان نوشتههای انسانی نیست؛ بلکه یعنی شرکتها برای یافتن دادههای تازه باید بیشتر به سراغ منابع آفلاین، آرشیوهای خصوصی و کتابهایی بروند که هنوز نسخه دیجیتال ندارند.
بهانه حقوقی شرکتها برای تکهتکه کردن کتابها
نابود کردن کتابها پس از اسکن، علاوه بر افزایش سرعت کار، دلیل حقوقی هم دارد. پیشتر شرکت «انتروپیک» (Anthropic) هم میلیونها کتاب را به همین روش اسکن و نابود کرده بود. در پرونده شکایت از انتروپیک، دادگاه این کار را مصداق «استفاده منصفانه» (Fair use) دانست.
از نگاه حقوقدانان کپیرایت، این فرایند صرفاً نوعی «تغییر قالب» از فیزیکی به دیجیتال است؛ به این معنا که چون با نابودی نسخه کاغذی، تعداد نسخههای موجود از یک اثر بیشتر نمیشود، نقض کپیرایت رخ نداده است. (البته این موضوع بهخودیخود آموزش هوش مصنوعی را قانونی نمیکند و دادگاه آن را جداگانه بررسی کرده است).
این روند خطر پنهانی برای حفظ آثار تاریخی دارد. همان ویژگیهایی که یک کتاب را به داده آموزشی ارزشمند تبدیل میکند، احتمال کمیاببودنش را هم بیشتر میکند. نگرانی اصلی این است که میان محمولههای بزرگ، نسخههای چاپتمام، امضاشده، حاشیهنویسیشده یا دارای ویژگیهای منحصربهفرد نیز بدون ارزیابی دقیق از بین بروند.
در نهایت: میراثی که فدای الگوریتمها میشود
ماجرای اسکن و نابودی کتابها نشاندهنده رویارویی عجیب فناوری با میراث فیزیکی است. در حالی که شرکتهای توسعهدهنده هوش مصنوعی برای باهوشتر کردن مدلهای خود به دنبال استخراج آخرین قطرههای دادههای اصیل انسانی هستند، بخشی از تاریخ مکتوب در حال تبدیل شدن به زباله است. تا زمانی که غولهای فناوری مانند آمازون شفافیتی درباره نحوه غربالگری این کتابها نشان ندهند، این نگرانی پابرجاست که بهای پیشرفت هوش مصنوعی، نابودی بیسروصدای نسخههای تکرارنشدنی و ارزشمند باشد.


آدرس مطلب: https://nooshdaroo.ir/news-opinion/amazon-scanning-destroying-books-ai-training/